[光流][ECCV2024 Oral]SEA-RAFT: Simple, Efficient, Accurate RAFT for Optical Flow
最近在看ICCV oral的时候,发现了一篇关于光流的paper,准备研读一下,就发现这篇SEA-RAFT是其前置base model,仔细一看还有点意思,并且其方案复现简单,就自己尝试了一下,确实有效,就想着写一篇文章简单介绍一下。
论文地址:
Motivation
作者提出了一种简单有效且准确的RAFT光流新方法。(没啥motivation,就是数值碾压)也符合CV会议的精髓,对于故事会的要求比ACL低多了。
Contribution
- 作者提出了一个Mixture of Laplace Loss
- 作者不是从0开始初始化,而是预测一个初始流来初始化
- 使用了刚性光流数据集做预训练
Method
Mixture of Laplace Loss:
这个loss其实就是这篇论文性能提升的主要来源。loss的假设是,光流本身具有不确定性,导致很多时候存在模棱两可的光流,有时候位移一个像素是对的,位移两个像素也是对的,这时候如果强制使用L1去学习的话,可能会学会一个偏执的,过拟合于训练集的错误光流,导致结果在测试集上不鲁棒。
作者认为这种时候的分布是基于拉普拉斯分布的,于是作者在预测光流的2个通道的同时,还预测了4个通道,他们分别是b通道以及weight通道。其中b通道是拉普拉斯分布的参数b,weight是一个区分的通道。作者的解释是用单一的拉普拉斯分布效果不好,所以他们用了2个拉普拉斯。
打个比方来说,你在给同学批改作业,每道题都是一个像素的答案,和标准答案有误差。大部分题目清楚易判,错一点就该扣分,所以让严格老师的来评分,错一点就狠狠的罚。而对于困难的题目,本身就模棱两可,很难打死板的分,那就让宽容的老师来评分。但是我们也不知道到底哪个题目是清楚的,哪个是困难的,所以让模型自己学了一个,来使用softmax来决定让哪个老师评分,这就是weight通道。简单来说,weight通道决定了方向(严格还是宽容),而b通道决定了振幅。(有多严厉以及有多宽容)为了让数值稳定一点,作者还用了对数形式来约束b。
公式可以直接看论文,说白了就是两个拉普拉斯分布mask加权求和,没啥意思
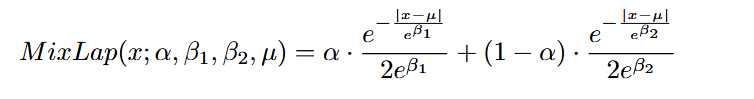
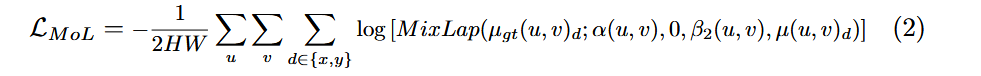
这个loss的具体实现源码里有现成的,不过在模型的forward里,不大常规,当时看的时候找了有好一会。地址在这儿https://github.com/princeton-vl/SEA-RAFT/blob/main/core/raft.py 感兴趣可以自己看一下,实现起来挺简单的。
Direct Regression of Initial Flow:
其实介绍完了这个loss,这篇论文已经没啥东西了,这里有一个初始流回归,说白了就是原来要初始化一个全0的张量然后在上面做refine,现在直接不用初始化了,前面的网络直接预测一个初始化的光流,然后在上面refine,感觉上除了加快收敛速度,其他没啥效果,事实上我自己做光流一直都是直接预测的,没想到这也能成为一个contribution。
Large-Scale Rigid-Flow Pre-Training:
使用刚性数据集,这个contirbution就更奇怪了,说实话我有点get不到,在我理解里,就是用了一个比flychair更简单的数据集做预训练,然后逐步换数据集加难度。
光流任务经常有这种,先训A,再训B,然后训C这种训练方式,看了这么多论文其实我一直没get到到底和直接一起训有啥区别,反正我自己先xxx,再xxx,和两个一起训久一点,在自己的实验里没发现有什么区别过。可能是属于肉眼感知不到,结果数值有优化的trick吧
Conclusion
这篇论文就写完了,当时看了挺久,还上手实现了一下。确实属于简单有效的方法,尤其是4通道在推理的时候还能丢掉。不增加额外算力,属于是0代价提升性能了。
不过这篇论文其实也存在一些问题的,比如:这个loss说白了,就是加权算loss,只不过是逐像素加权罢了。那么让模棱两可的部分权重小了,如果这个模棱两可的地方正好很重要应该怎么办?毕竟工程不是写论文,真用起来可不是给甲方报个数字就行了。又比如,这个方法刚需光流gt,但是事实上大部分光流任务都是自监督无监督的,有监督gt的光流数据集真的不多,而且性能受限于gt光流也是一个问题。还有一个就是,raft的通病,开销比较大,端侧基本用不了。(今年ICCV要处理的问题,下篇讲)