[盲去闪烁][ECCV 2024]BlazeBVD
故事会环节:
这篇文章的故事首先从标题开始,看完题目就想大喊一声maga,感觉比之前的bert,eva啥的还有梗。
然后就是正常的讲故事了,视频在现代社会很重要,但是视频闪烁很影响视频质量,所以要去闪烁。过去有一堆方法来做去闪烁。(说实话,小领域这么写是为了和审稿人解释重要性,BVD是啥。做的多的方向就不用这么写了,审稿人一眼觉得在水字数)
尽管有这么多方法,但是这些方法都有些不足之处,性能不佳。文章分析有这些情况的原因是因为:( i )产生的视频中存在部分颜色伪影和失真,导致颜色保真度和细节与原始视频相比存在差异;( ii )由于光照引起的过度曝光或曝光不足会导致纹理细节的显著丢失,并引入新的局部闪烁。随后开始分析,前面两个情况的成因是视频数据中的时空复杂性。(说实话看intro我并不能理解前面两个状况和时空复杂性有啥关系,时空复杂,那得告诉我在单帧图像上没这个问题吧)
然后开始写本文是怎么解决这个时空复杂性的,通过使用STE提出的像素分布的直方图来解决这个问题,总共3步,首先,引入STE对光照空间下的视频帧直方图序列进行矫正。其次,由于矫正完之后的光照图具有稳定的时间性能,将其作为2D空间网络的全局闪烁去除模块( GFRM )的提示条件,以指导视频帧的颜色校正。并设计了,局部闪烁消除模块( LFRM )基于光流偏差来恢复图像。最后,我们引入了一个3D网络来处理所有的帧,其中设计了一个自适应的掩码加权扭曲损失来提高视频的连贯性。
创新点:
- 首次把直方图用到BVD领域里去
- 设计了一个全局-局部去闪烁模块
- 使用了一个2D-3D网络
STE平滑:
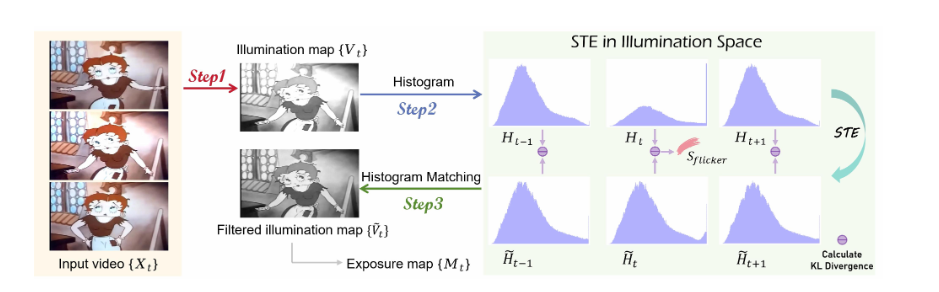
这里应该算是这篇paper的主要贡献了,使用了STE的方法,把视频帧当中的异常图像做了个校准与平滑
2d 全局-局部网络:
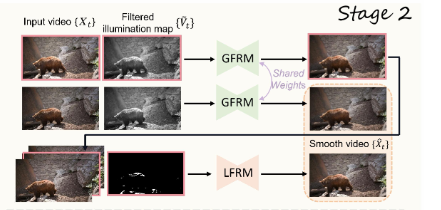
这篇论文最抽象的地方来了,不知道是不是我看的版本的问题,这论文居然对于整个网络只有这么简单的一张图,中间的GFRM模块说是简单的2d U-net,LFRM直接就没说是啥,看图也是个unet,唯一的区别估计就是一个拿滤波图像,一个是拿光流过了一下,结构估计是一模一样的。(猜的,好像也没公开代码)说实话,简单的u-net还是好几个,都能加速10倍了,以前BVD都是咋做的不是很清楚。
3d模型
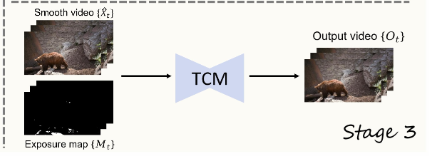
和上面一样,依旧没有结构,我姑且认为这个TCM和上面的GFRM,LFRM模型代码是一模一样的吧,损失函数的目标和输入输出不一样,maybe~
总结:
看Arxiv好像是被CVPR拒了转投的ECCV,但是说实话除了那个不知道有没有用的STE,从消融上看还挺有用的,但是对比的对手感觉性能也太差了。另外的网络,结构也没给,不知道是怎么过的审稿人。可能因为BVD做的人真的很少吧。