[降噪][ECCV 2022]NAFNet
故事会环节:
在图像复原领域,深度学习方法很好用,在SIDD和GoPro上都取得了成功(写这个那大概率就是后面的对比数据集了)。然后就开始写,尽管方法好用,但是模型越来越复杂。作者将模型复杂度分为了块间复杂度和块内复杂度。现在的sota模型,不是块间复杂度巨高,就是块内复杂度巨高(说白了,块间复杂度就是堆block,块内复杂度就是在一个block里做各种连接,各种设计,这里的块指的是一个unet架构)
既然有这些复杂度的问题,那作者自然就是要用一个块间块内都简单的模型来获取sota了。(不得不说,逼好吹,谁不知道简单性能高厉害,但是厉害就厉害在吹的实现了)。作者首先做了一堆消融实验,然后得到了一个baseline。(最离谱的是这个baseline就已经是sota了,理论上这就已经能发一篇了)。然后NAFNet就是这个baseline的简化版本。用元素乘积代替GLU来等效GELU激活函数。同时CA也可以被一并取代,性能取得了更高的SOTA。
创新点:
- 创建了一个sota水平的简单baseline
- 分析了GELU,通道注意力等的联系,对baseline进行化简,取缔了激活函数
创建baseline
创建理念就是奥卡姆剃刀原则,如无必要,勿增实体,从一个卷积,relu的残差块开始改进。然后加入了layer normal(这个真的很重要),然后再把relu换成gelu。同时为了讨论注意力,加入了通道注意力(性能提升不大,还专门说了不得不比较,估计是一开始投稿被审稿人怼了,没办法加了一个)。(不过这篇论文真的挺讽刺的,按照它的实验来说,一个残差块加LN,加GELU,加一个通道注意力,就已经取得了sota了,那之前茫茫多的方法到底再干嘛emmmm)
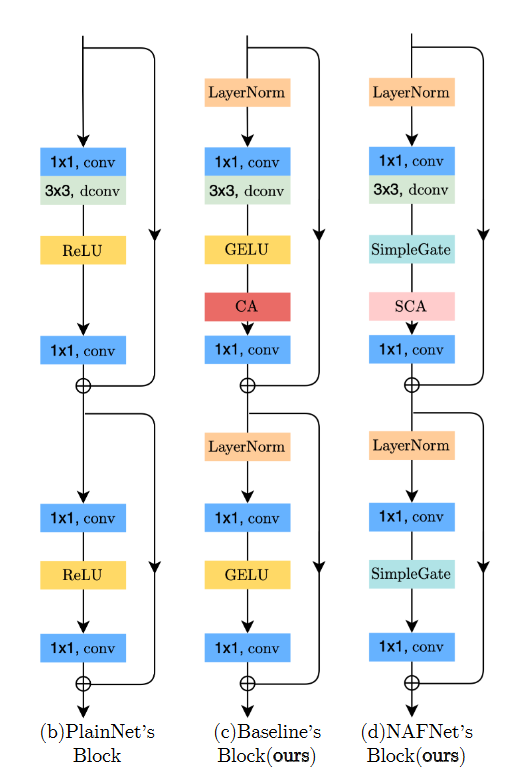
NAFNet:
GLUE简化:
作者通过分析发现,GLU的公式,和GELU的其实差不多,GELU其实是GLU的变体,f和g都取恒等映射,σ 取ϕ ,两个公式就等价了,GELU其实是特殊形式的GLU,
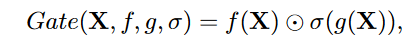
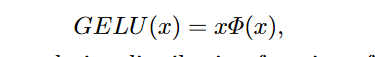
然后作者猜测,可能是GLU这个结构,本身就有非线性的性质,所以要不要激活函数都可以,于是提出了SimpleGata,拿两个map乘一下。
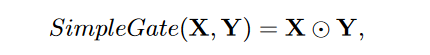
CA简化:
作者发现CA其实本质上,好像和GLU也很像,
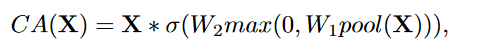
于是提出了SCA,用GLU化简了CA的结构
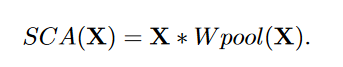
总结:
作者通过实验设计了一个很简单的结构,就达到了sota水平,同时分析了如何去除非线性,虽然作者说的主要贡献在于什么第一个去除了非线性啥的。但是可能对我自己来说,这个有没有非线性其实除了让故事更好听,没啥作用,因为最垃圾的芯片也支持relu,发论文可能故事很好,很novelty,但是真的要用,越简单越实用越好。这篇最大的贡献在我看来,其实是点出了,明明很简单的u-net base网络,很简单的改了改,没有复杂的连接,没有复杂的任务分化,就能达到了sota的水平。对于之前的各种大算力,堆参数量然后还说是自己的模型设计多精妙的工作,其实挺打脸的。看的出来旷视真的在搞工程,没有在无脑水论文。