[降噪][TSMC 2024]HWformer
故事会环节:
上来先讲图像去噪的定义,然后经典传统算法怎么样,深度学习怎么做。然后着重引出使用Transformer的图像去噪是怎么做的,分为长距离。(虽然引用的paper我就见过SwinIR)。然后说它们有啥问题,窗口Transformer会限制上下文交互,正常的Transformer会增加去噪时间,于是提出了HWformer,设计了一个异构的全局窗口,既保证了上下文的信息,又进行窗口移动。(读到这儿其实我很疑惑,都全局了还怎么移动,一动不就出去了么,继续往下看)又说为了更好地提取patch之间的局部信息,将稀疏方法嵌入到前馈网络中,防止独立处理图像块带来的负面影响。最后比Restormer快了70%。
创新点:
- 设计了异构全局窗口(GTEB)
- 设计了全局窗口的平移方式(TDEB)
- 在前馈网络中提出稀疏技术
Method:
带着读intro的好奇,来到method部分,后来发现,原来论文里这个全局窗口和平移方式不是一回事,而是两件事儿
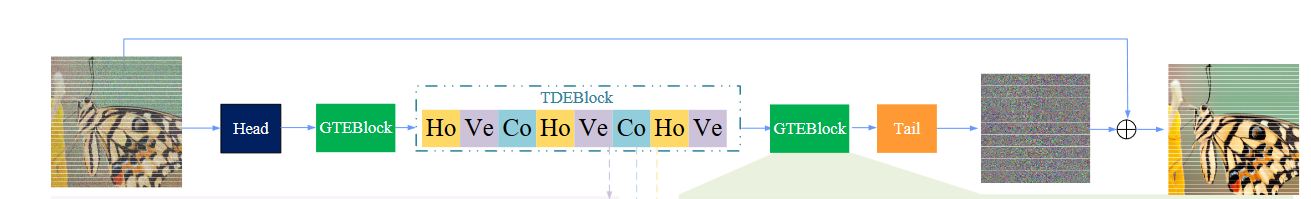
网络本质上是先做了一个全局transformer(GTEB),然后再做这个平移的transformer(TDEB)最后再输出,在我自己看来,这就是先全局再局部的操作。说实话有点小失望,本来比较好奇,全局平移是个怎么的实现方式。
GTEB
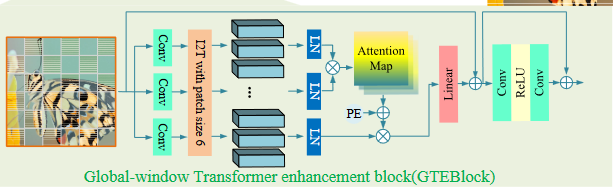
说是全局Transformer,做法为用96size的窗口替换源代码里48size的窗口,然后复制三份过了3个卷积再做attention,然后把attention里的mlp改成卷积,减小点网络尺寸(这个操作其实不是很清楚为啥,如果后面实验有参数比较,那可能是为了控制参数量)
TDEB
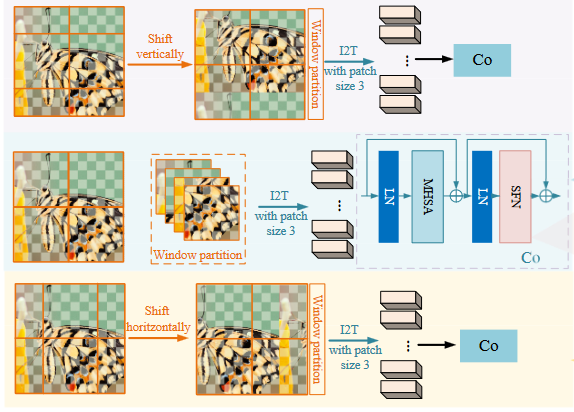
TDEB做了一个多方向移动的操作,从上到下分别是Ve,Co,Ho,不过这个图应该是画错了,黄色的Ho出去应该是Ve块才对,分别是左右平移,上下平移,还有正常窗口
稀疏技术
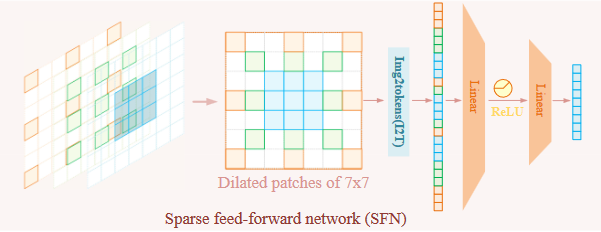
论文里就提了一嘴,可能是类似,大空洞核的空洞卷积?没看代码不是很清楚细节,不过我猜测应该,没啥用,也是个降低内存开销的,估计是前面的全局transformer带来的内存开销太吓人了,只能在后面找补。后面消融实验也显示,用了这个大空洞卷积,提升了0.03,说实话和没有没啥区别,正常训练误差
实验
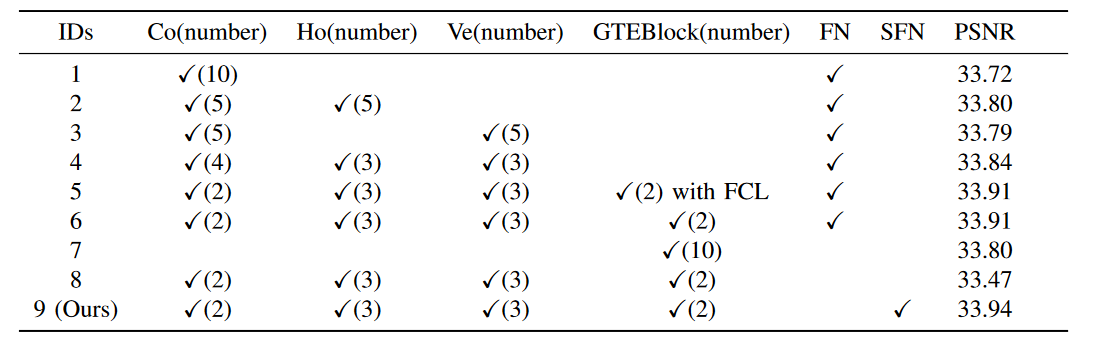
实验比较让我在意的是表1,做了一组消融,但是10个co,说白了就是堆10个transformer块有33.72的性能,改成10个GTEB,没加fn,就有33.80,猜测可能加了性能就超过作者的方法了,所以没放上去。不过也正常,这个GTEB参数量一看就很大,放了不涨点才奇怪嘞。
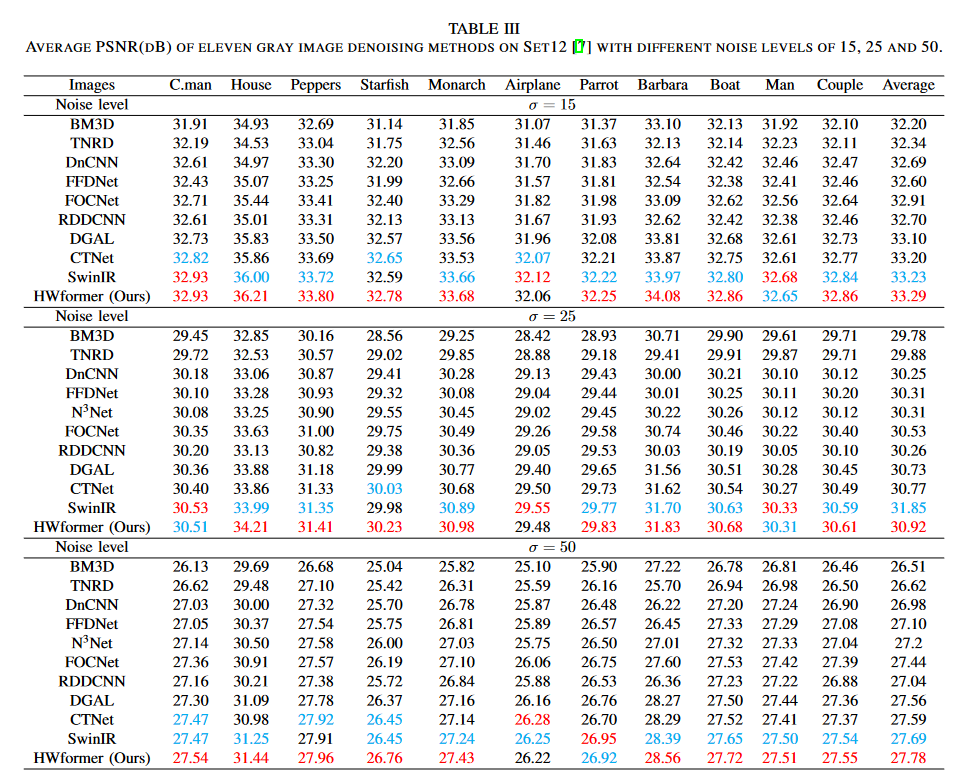
对比方法比较的是SwinIR,我如果没记错,这应该是21年的论文了,24年的论文比较一篇21年的,感觉略显不够,可以找近一点的方法比较一下。
总结:
论文提出了一种,全局局部Swin的方法,设计了全局transformer和不同方向的transformer,捕获上下文关系提高了性能。优点:实验非常充分,10页论文做了7页实验。缺点:性能确实一般,比较方法比较老旧,不知道是不是因为论文很早就写完了,但是审稿周期太久。虽然SwinIR是当时的断档sota,但是和21年的方法打的有来有回不说,也没提参数量比较,我不确定如果SwinIR同参数量性能会不会更好。